Содержание 4
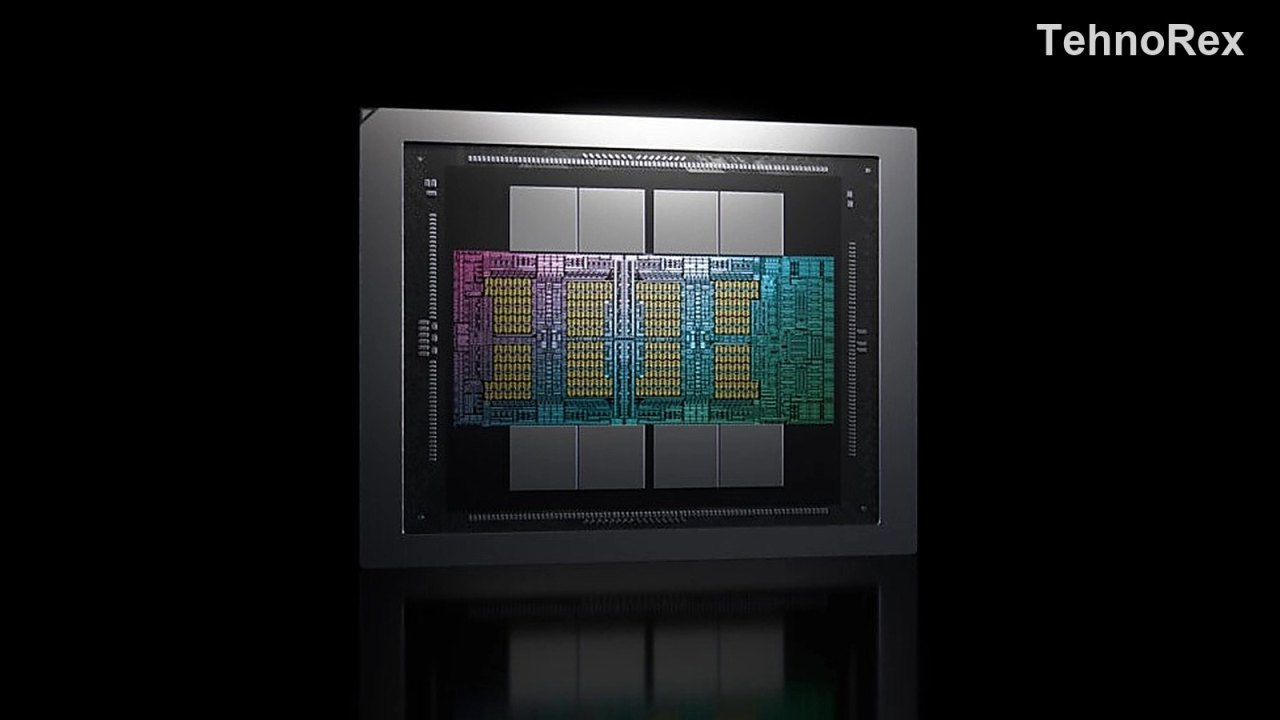
Nvidia представила графический процессор Rubin HPC. Это не очередной ускоритель для обучения больших языковых моделей, а чип для высокопроизводительных вычислений общего назначения.
Главная особенность — количество ядер CUDA. Компания подтвердила, что их более 50 000, и это делает Rubin HPC крупнейшим GPU в истории Nvidia по этому показателю. Обычный Rubin, ориентированный на задачи искусственного интеллекта, имеет 28 672 ядра.
Чип входит в платформу Vera Rubin. Он рассчитан на научное моделирование, инженерные расчёты и сложную аналитику данных — то есть на задачи, которыми суперкомпьютеры занимались до того, как это стало мейнстримом из-за нейросетей.
Что даёт NVLink 7
Помимо ядер, Rubin HPC получил поддержку седьмого поколения интерфейса NVLink. Это шаг вперёд даже относительно обычной архитектуры Rubin, где используется NVLink 6.
Такой апгрейд позволяет объединять чипы в крупные кластеры с высокой скоростью обмена данными. Архитектура Rubin, анонсированная в 2024 году, обещает пропускную способность памяти до 22 ТБ/с, что заметно выше показателей Blackwell Ultra.
Конкуренция и сроки
На рынке HPC Nvidia будет соперничать с серией AMD Instinct MI400. Конкуренты тоже делают ставку на память HBM4 и научные вычисления, так что борьба за суперкомпьютеры в 2028 году обещает быть содержательной.
Именно на 2028 год запланирован выход Rubin HPC в составе платформы Vera Rubin. Платформа включит не только графические чипы, но и центральный процессор Vera — наследника Grace 2024 года — с 88 ядрами на архитектуре Olympus.
Зачем это вне дата-центров
Разделение линеек показательно. Рынок ИИ растёт быстрее, но научные расчёты никуда не делись, и производители возвращаются к ним с новыми возможностями.
Для обычного пользователя это отражается косвенно — через цены и доступность памяти. CXMT запускает HBM3E, и появление альтернативных поставщиков постепенно меняет расклад. О том, как это влияет на комплектующие, мы писали в материале про рост цен на память.
Почему ядер так много
Научные задачи плохо ложатся на тензорные блоки, которые ускоряют нейросети. Моделирование климата, расчёт прочности конструкций или обработка данных с телескопов требуют другой арифметики: двойной точности и большого числа независимых вычислений.
Именно поэтому производитель увеличивает количество классических ядер, а не блоков для матричных операций. Такой чип бесполезен для обучения моделей, но незаменим там, где нужна точность, а не приблизительный результат.
Отсюда и разделение линеек. Покупатель дата-центра выбирает между двумя разными инструментами, и универсального решения здесь нет — это признают и в Nvidia, и в AMD.
Ещё про Ноутбуки и ПК
Все материалы →