Содержание 5
Компания Inception представила диффузионную модель Mercury 3, которая генерирует текст не последовательно, а параллельно. По заявлению разработчиков, она в 6–8 раз быстрее GPT-6 Luna и выдаёт более 1000 токенов в секунду. При этом контекст достигает миллиона токенов.
Как работает Mercury 3
Обычные языковые модели, в отличие от Mercury 3, пишут слово за словом, поэтому скорость ограничена последовательным процессом. диффузионная модель генерирует сразу блок текста и постепенно его уточняет. Такой подход требует другого обучения, но даёт выигрыш по задержке.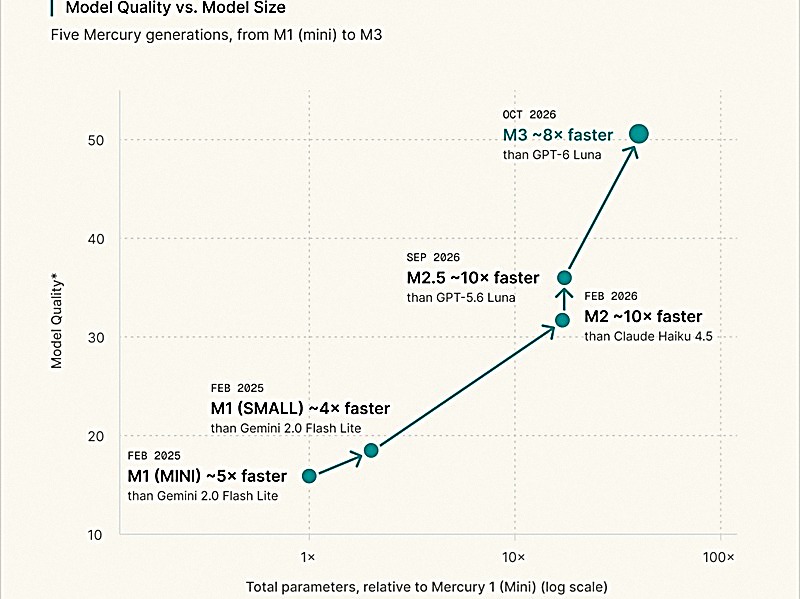
Почему скорость важна
В чат-ботах задержка раздражает пользователя, и здесь Mercury 3 выигрывает, а в агентных сценариях она напрямую влияет на стоимость. Быстрая модель может выполнить больше шагов за то же время и дешевле. Для бизнеса это значит, что автоматизация станет выгоднее.
Что с качеством
Диффузионные модели исторически уступали классическим в сложных рассуждениях. Inception утверждает, что новая модель сократила разрыв, но независимых тестов пока мало. Поэтому сравнивать её с флагманами стоит осторожно, особенно в задачах на логику.
Кому это интересно
В первую очередь разработчикам приложений, где важна мгновенная реакция: поиск, поддержка, генерация кода. Для редакционных задач скорость тоже полезна: черновик появляется быстрее. Однако для финальных текстов качество остаётся важнее скорости.
Отдельная тема — стоимость инференса: быстрые модели требуют меньше времени на запрос, но больше памяти при генерации блока. Для разработчиков важен баланс: новая модель может оказаться дешевле в пересчёте на ответ. Пока тарифы не объявлены, судить рано.
Похожие решения уже появлялись: диффузионные текстовые модели тестировали несколько стартапов. Однако до сих пор они уступали классическим в связности текста. Система утверждает, что разрыв сократился, и именно это делает её интересной.
Похожие материалы: самокопирование ИИ и рекорд Quantinuum. О модели пишут 3DNews и The Next Web.
Если результаты подтвердятся, диффузионный подход станет серьёзной альтернативой классическим моделям. Пока же это многообещающий эксперимент с очень высокой скоростью. Для пользователя это значит более быстрые ответы без долгого ожидания.
Читайте также: TLS-сертификаты eMudhra.
Текст: TehnoRex
Для разработчиков модель интересна ещё и как эксперимент: она показывает, что архитектура модели может быть такой же важной, как размер. Возможно, за диффузионным подходом будущее. Для пользователя это значит более быстрые ответы без долгого ожидания.